En Liquid Studio llevamos tiempo trabajando con agentes de IA que programan solos. Les das una lista de tareas y un agente las va resolviendo una detrás de otra, sin que nadie tenga que estar pendiente de cada paso. Nos ha permitido sacar adelante trabajo que antes pedía mucha más atención. En este artículo contamos cómo lo hemos ampliado para poner varios agentes de IA en un mismo proyecto, por si trabajas con agentes o te lo estás planteando.
Cuanto más lo usábamos, más claro veíamos lo que le faltaba, y lo resumimos en dos objetivos.
El primero era la calidad. En un equipo, el código no pasa directamente de quien lo escribe a producción: alguien comprueba que hace lo que se pidió, alguien revisa cómo está escrito y después se integra. Con un único agente, el que programa es el mismo que decide que el trabajo está bien. Queríamos que cada tarea pasara por varias fases y que cada fase la hiciera un agente distinto.
El segundo era tener una visión global. Con el enfoque habitual, la lista de tareas vive en un fichero dentro del proyecto, en el ordenador donde corre el agente. Así es difícil ver cómo va el desarrollo, revisar lo que se ha hecho, añadir una tarea a medio camino o poner a varios agentes en el mismo proyecto. Queríamos centralizarlo en un tablero estilo Trello, con todos los proyectos, el estado de cada tarea y su pull request, y con flujos de trabajo distintos según el tipo de proyecto.
El resultado es ralph-wiggums, que hemos publicado como código abierto. Montar la infraestructura para que un agente trabaje sobre sistemas reales es también parte de nuestro servicio de inteligencia artificial. Más abajo explicamos cómo funciona y por qué tomamos cada decisión.
El punto de partida: el patrón Ralph
Nos basamos en un patrón de Geoffrey Huntley que se llama Ralph. Parte de una observación: un agente que trabaja mucho rato en la misma sesión acumula intentos fallidos, ficheros que ya no importan y decisiones descartadas, y razona peor cuanto más ruido arrastra. Ralph lo evita con un bucle que lanza un agente nuevo para cada tarea. El agente empieza sin memoria, hace una sola cosa y termina. Lo que necesita saber lo encuentra en el repositorio: el código, el historial de git y una especificación.
Ryan Carson lo convirtió en una herramienta, snarktank/ralph. Un script lee una lista de tareas de un fichero, lanza un agente para la siguiente pendiente y repite. Lo que aprende cada agente queda apuntado en otro fichero para el siguiente.
Esa es la base. Todos los cambios que explicamos a continuación salen de algo que nos fallaba al usarla.
Las tareas en un sitio central
Mientras la lista de tareas sea un fichero en una sola máquina, nadie más puede ver el estado, añadir tareas ni trabajar en paralelo. Así que la sacamos a un servidor con una API pequeña.
El servidor guarda los proyectos y sus tareas. De cada tarea guarda la especificación, que escribe una persona y sirve de referencia para cualquier decisión; un estado mínimo con la fase en la que está, su pull request y si está atascada; y un historial de todo lo que le han hecho los agentes, con quién trabajó en ella, con qué resultado y qué dejó escrito.

Encima de la API hay un tablero con las tareas en cuatro columnas: pendientes, en curso, paradas y hechas. Cada tarjeta muestra la fase de la tarea, quién la está trabajando, el enlace a su pull request y, si algo va mal, el motivo. Las tareas se pueden editar o añadir con el desarrollo en marcha, y los agentes las recogen en su siguiente vuelta.
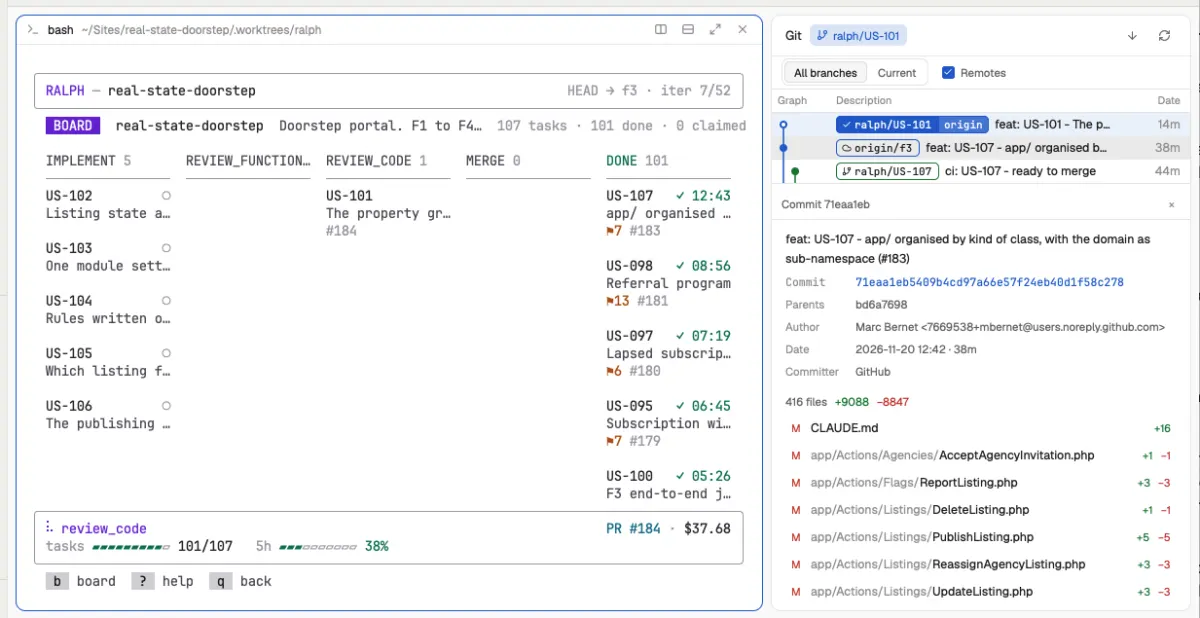
Cada worker tiene también su propia vista en la terminal. Esta es la de un proyecto real con 107 tareas, ordenadas por la fase en la que está cada una:
Varios agentes de IA sin pisarse
Con dos agentes en el mismo proyecto, tarde o temprano los dos cogen la misma tarea si nadie lo impide. Por eso reparte el servidor.
Cada agente corre dentro de lo que llamamos un worker: el script de Ralph sobre su propia copia del repositorio, en cualquier máquina con acceso al servidor y a GitHub. Cuando un worker pide trabajo, el servidor elige una tarea y se la reserva durante dos horas. Elegir y reservar es una sola operación, de modo que dos workers nunca reciben la misma tarea.
El orden de reparto intenta no tirar trabajo. Un worker recibe primero las tareas en las que ya estaba, porque tiene la rama en local; después, tareas nuevas; y al final, las que dejó otro worker. Dentro de cada grupo salen antes las más avanzadas, para cerrar antes de abrir, y una tarea nunca se entrega mientras haya tareas de las que depende sin terminar.
Solo el script habla con el servidor. Si el agente tuviera acceso a la API, podría coger una tarea que no le toca o dejar el estado a medias. Por eso recibe la información de su tarea, hace el trabajo y deja el resultado en un fichero, que el script valida antes de enviarlo. El agente nunca ve las credenciales.
Memoria compartida
Cada agente empieza sin memoria, y uno que no sabe qué han hecho los anteriores acaba repitiendo trabajo o rompiendo lo que ya funcionaba.
Para evitarlo, el agente recibe con su tarea todo el historial de esa tarea y un resumen de cada tarea ya terminada en el proyecto. El historial le cuenta qué se intentó y qué comentaron los revisores. Los resúmenes le dicen dónde está cada cosa en el código: un agente que empieza una tarea sobre el movimiento de las piezas de un juego ya sabe en qué fichero está ese código, porque lo dejó anotado el agente que lo escribió.
Quien programa no aprueba
Si el agente que escribe el código es el mismo que decide que está terminado, un malentendido de la especificación pasa sin que nadie lo vea. Por eso cada tarea pasa por varias fases, y cada fase la hace un agente distinto que empieza de cero. El flujo por defecto es el de un equipo:
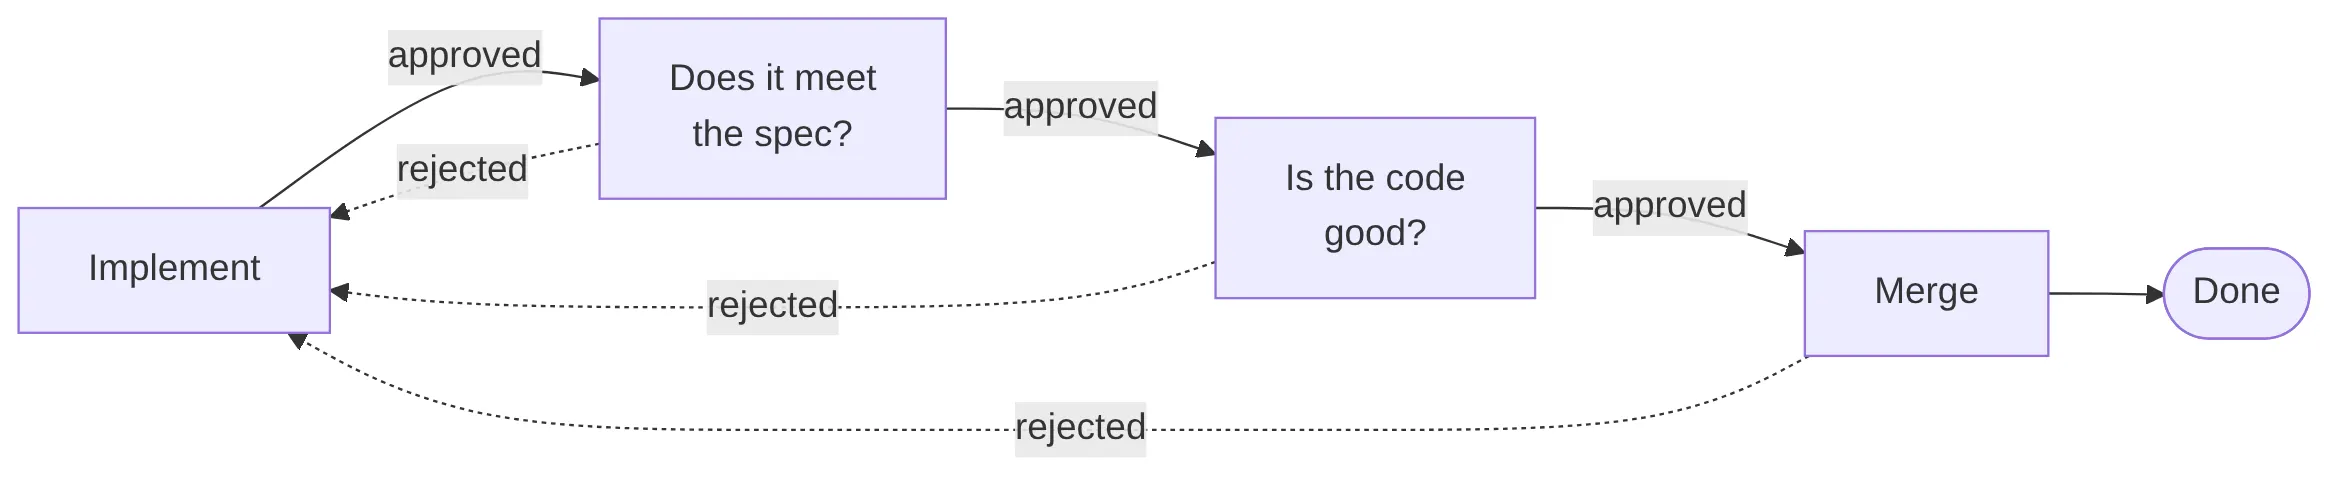
El primer agente implementa y abre el pull request. El segundo lo compara con la especificación sin saber cómo se escribió. El tercero revisa la calidad del código. El último actualiza la rama, espera a que pasen los tests, mergea y escribe el resumen de la tarea.
Los revisores arreglan lo que pueden en la misma rama y aprueban. Las tareas son pequeñas, así que casi siempre sale más a cuenta corregir en el momento que devolver el trabajo. Cuando el problema es de fondo, rechazan la tarea y esta vuelve a la primera fase con su comentario en el historial, que el siguiente implementador lee antes de empezar.
Cada proyecto define sus propias fases. El servidor no sabe qué hace cada una; solo distingue la primera, que crea el pull request, las intermedias, que pueden rechazar, y la última, que cierra la tarea. Un proyecto sencillo puede quedarse en implementar y revisar, y otro puede añadir una fase de seguridad. Para añadir una fase basta con escribir sus instrucciones.
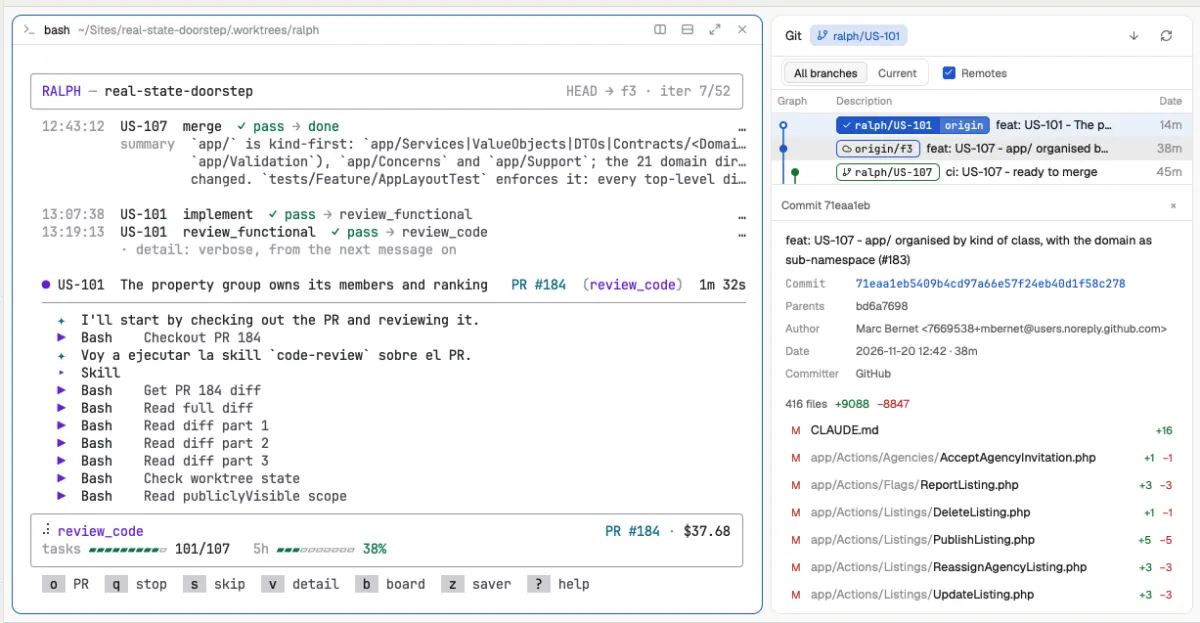
Mientras trabaja, la vista del worker enseña las fases por las que ha pasado cada tarea y lo que está haciendo el agente en ese momento. En esta captura, el revisor de código acaba de recibir el pull request #184:
Una prueba con un Tetris
Para probarlo escribimos la especificación de un Tetris para macOS en Rust. Eran unas 400 líneas con las piezas, las rotaciones, la velocidad de caída por nivel, la puntuación, los controles y el dibujo de la pantalla. El proyecto de partida solo abría una ventana vacía.
Un agente dividió la especificación en doce tareas y nos las enseñó antes de cargarlas. Fue el único momento en el que intervinimos, y es donde más pesa el criterio de una persona, porque cómo se parte el trabajo condiciona todo lo que viene después.
A partir de la cuarta tarea pusimos a implementar a Haiku, el modelo más barato de Anthropic, y dejamos a Opus en las revisiones. Queríamos ver qué pasaba con un implementador más débil y revisores más fuertes.
Los revisores encontraron tres errores. La comprobación de colisiones de las piezas estaba escrita dos veces, y el revisor de código la dejó en un solo sitio. El segundo tenía que ver con el suelo: cuando una pieza lo toca tiene medio segundo para moverse, y cada movimiento reinicia ese tiempo, como mucho quince veces. El código de Haiku permitía saltarse ese límite girando la pieza, así que una pieza podía no fijarse nunca. Ningún test lo cubría; el revisor lo corrigió y añadió el test. El tercero lo encontró el revisor que compara con la especificación: las piezas nuevas tardaban dos segundos en aparecer en pantalla, la especificación pedía otra cosa y lo corrigió.
En algo más de una hora de trabajo de los agentes teníamos un Tetris completo y jugable, con un pull request mergeado por cada tarea terminada. Claude Code calcula un coste equivalente de unos 12 dólares; con una suscripción, lo que se gasta es parte del límite de uso.
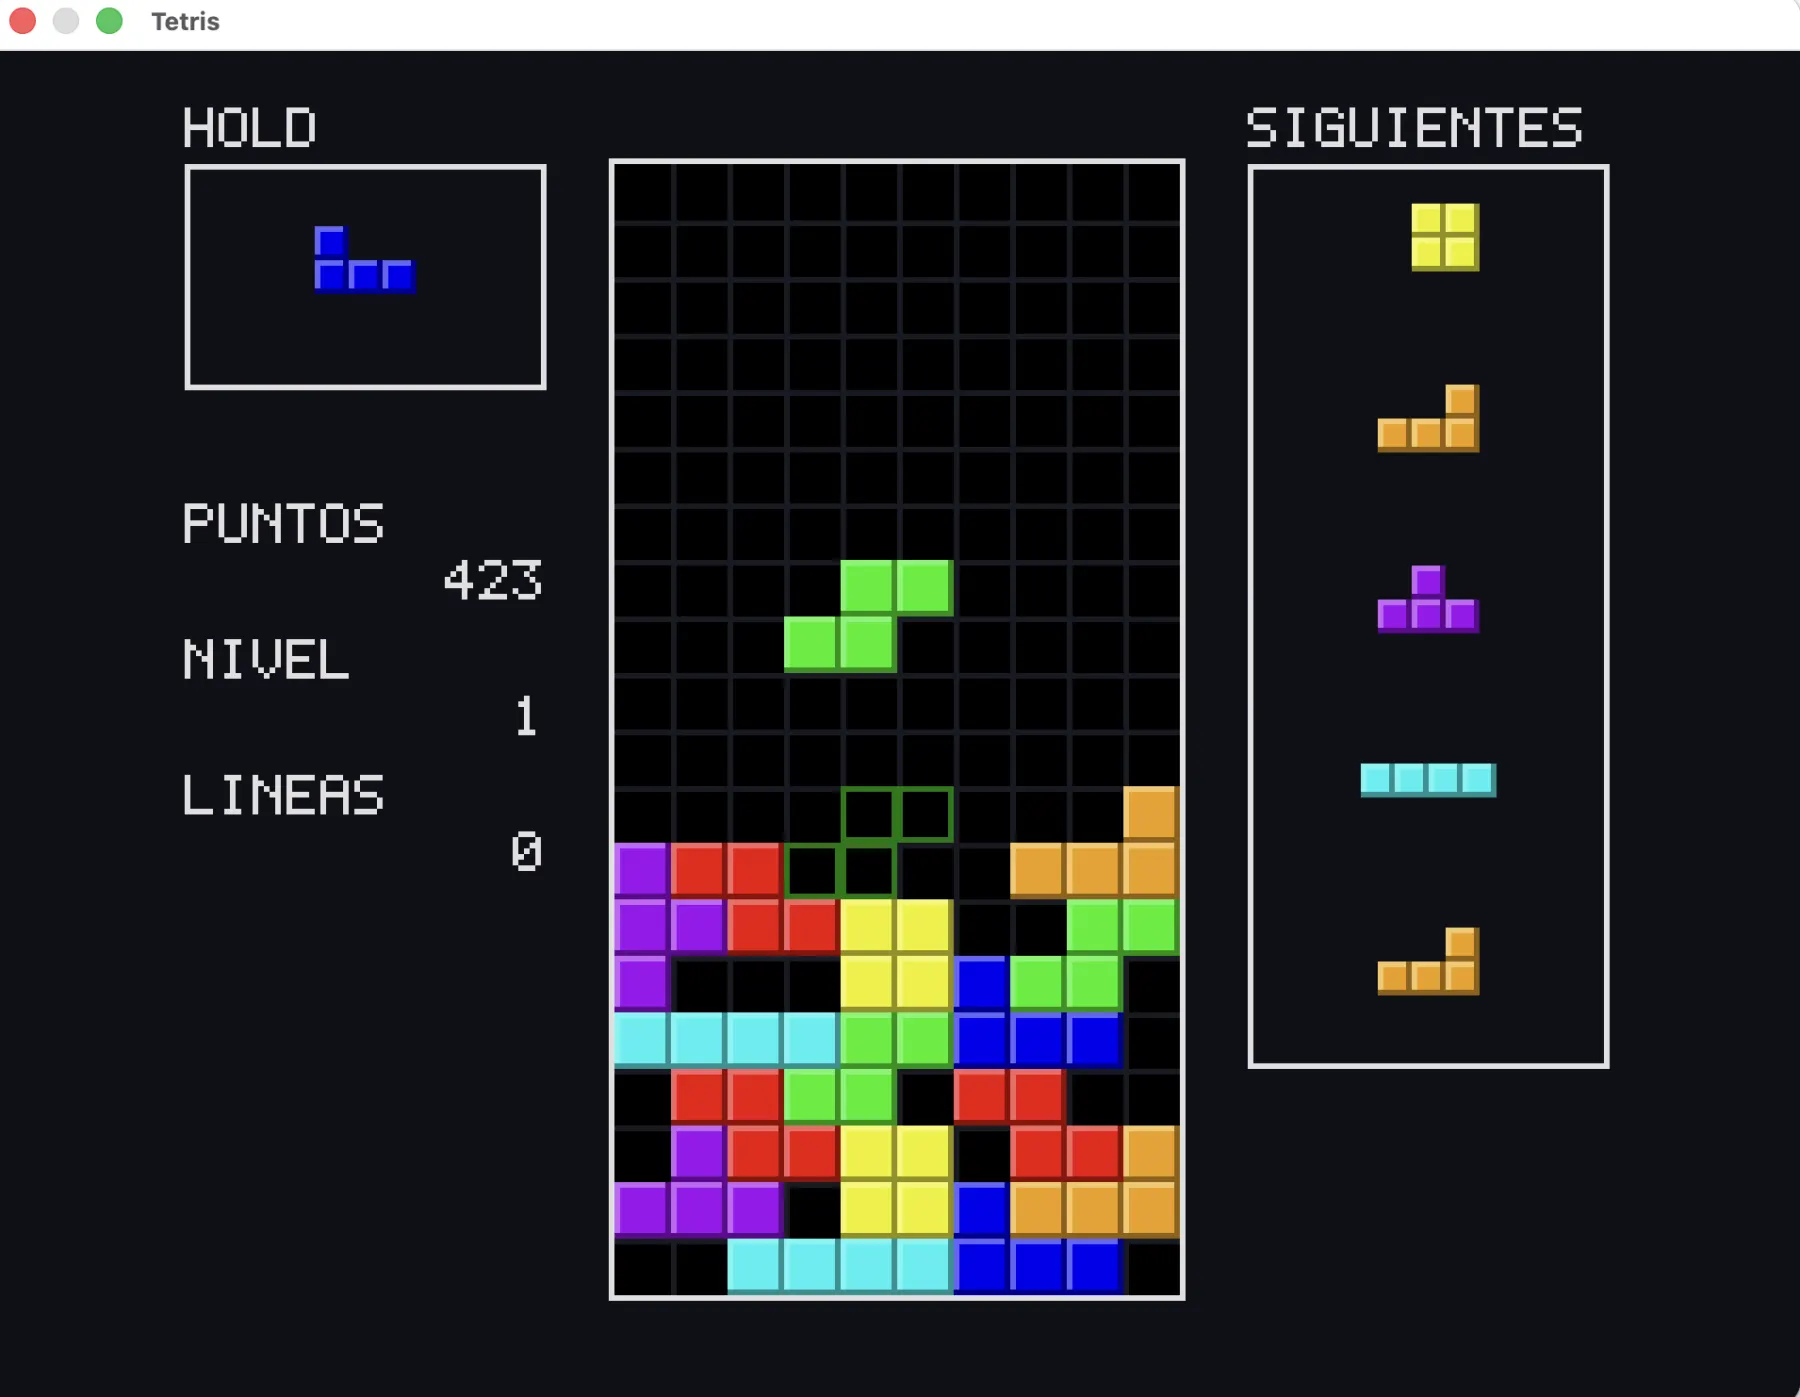
El Tetris que hicieron los agentes, funcionando en macOS
Cuando una tarea no puede avanzar
Un agente que trabaja solo no tiene a quién preguntar. Si se atasca, puede inventarse una salida o quedarse dando vueltas sin fin, así que hay una respuesta para cada nivel de gravedad.
Ante una ambigüedad, el agente elige lo que mejor encaja con la especificación y deja escrita su suposición para que la vean los revisores.
Cuando no puede avanzar porque el entorno está roto, falta un acceso o la especificación se contradice, marca la tarea como atascada y explica por qué. La tarea pasa entonces a un agente especializado, al que llamamos doctor, que investiga la causa y decide qué hacer con ella.
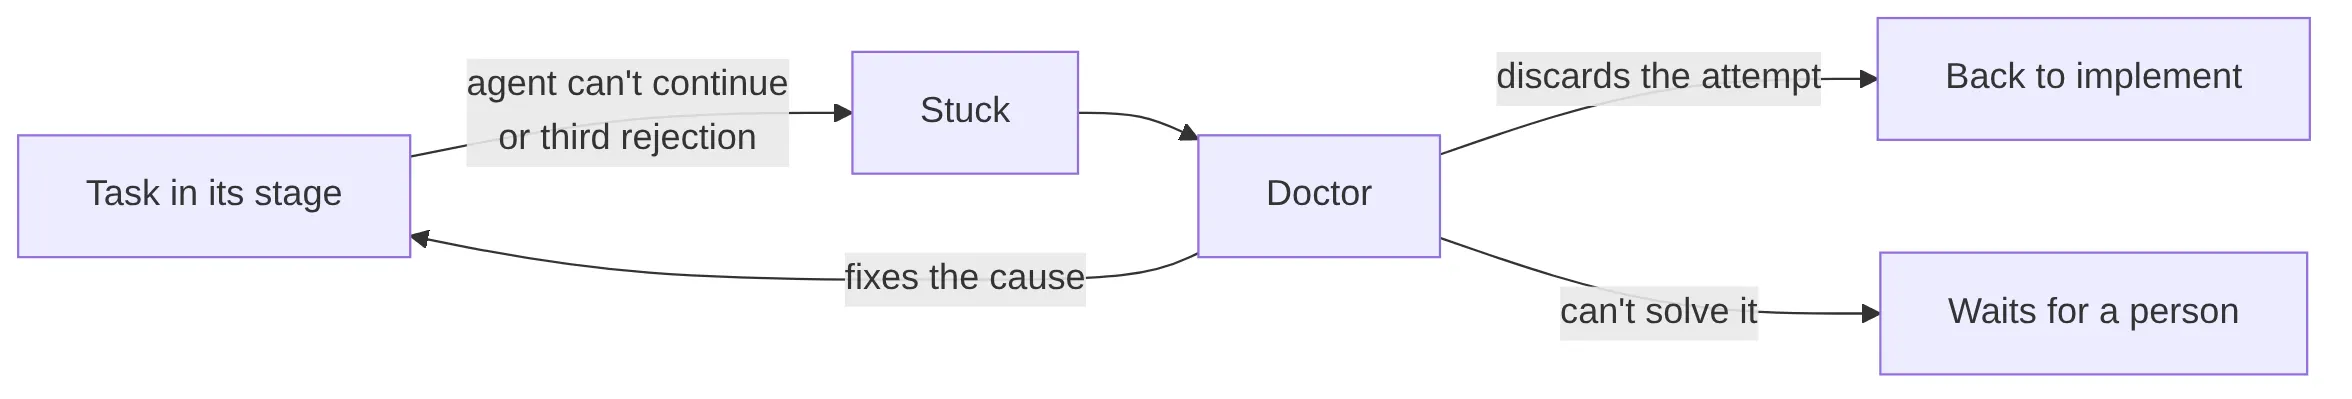
En el Tetris pasó con un error nuestro: la especificación daba dos velocidades distintas para el nivel 1. El agente no escribió código y explicó la contradicción. El doctor dedujo qué valor era el correcto, corrigió la especificación y la tarea siguió.
Los límites son fijos para que ningún ciclo se repita sin control. Una tarea rechazada tres veces pasa al doctor, y el doctor interviene como mucho dos veces en la misma tarea. Si no lo resuelve, la tarea se para junto con las que dependen de ella y aparece en la columna de paradas del tablero, con el diagnóstico.
El consumo bajo control
Una suscripción de Claude tiene dos límites de uso, uno que se reinicia cada cinco horas y otro semanal. Un bucle que trabaja solo puede agotar el de la semana en una noche, de modo que el worker vigila su ritmo antes de cada ejecución. Si va más rápido de lo que le permitiría acabar la ventana de cinco horas sin pasar del 85 %, hace una pausa. Si la siguiente ejecución superaría el límite, espera a que se reinicie, y si se agota el límite semanal, se detiene.
En el Tetris, el worker llegó a llevar un 31 % consumido a la hora y tres cuartos de ventana. Como iba algo rápido, esperó tres minutos y medio y siguió.
También se puede elegir qué modelo hace cada fase. Con dos líneas de configuración, el modelo barato implementa y las revisiones usan uno mejor:
RALPH_STAGE_IMPLEMENT=low
RALPH_MODEL_LOW=haiku
Es la combinación que mejor nos ha funcionado: el modelo barato hace el grueso del trabajo y los revisores corrigen lo que se le escapa.
Tres workers a la vez
La segunda prueba fue un programa de ajedrez para la terminal, con tres workers en paralelo y Haiku en todas las fases, revisiones incluidas.
Tres tareas distintas necesitaban el mismo fichero y cada una lo creó desde cero en su rama. La primera se integró sin problemas y la segunda entró en conflicto con ella. El agente de la fase de merge combinó las dos versiones, renombró una función que aparecía en ambas, pasó los tests, mergeó y dejó escrito cómo lo había resuelto para quien tuviera que integrar la tercera.
Una de las tareas pasó por los tres workers. Uno la implementó, otro revisó el código y el tercero la mergeó, sin que ninguno supiera de los otros: el servidor dio cada fase al worker que estaba libre. Fueron catorce tareas en media hora, con un coste equivalente de 65 céntimos.
Ajustar las instrucciones
Los agentes cometen errores que se repiten, y corregir cada resultado a mano no escala. Huntley propone corregir las instrucciones, y lo compara con afinar una guitarra. Es la parte que más tiempo nos ha llevado, y casi nunca ha hecho falta una regla nueva. Suele bastar con formular mejor una que ya existe.
Por ejemplo, los agentes solo veían las tareas terminadas, no las pendientes, y a veces dejaban trabajo "para una tarea posterior" que no existía. Lo resolvimos ampliando una regla que ya tenían:
- **Decide instead of asking.** Nobody is there to answer.
+ **Decide instead of asking or deferring.** Nobody is there to answer, and no later task is promised.
Conviene tocar lo mínimo. Unas instrucciones que funcionan son frágiles, y un párrafo nuevo puede cambiar comportamientos que no tenían nada que ver con lo que querías arreglar.
Lo que no resuelve
La especificación sigue siendo trabajo de una persona. Todo lo que salió bien en estas pruebas partía de especificaciones con criterios de aceptación comprobables; con una especificación vaga, los agentes rellenan los huecos con suposiciones.
Solo lo hemos usado en proyectos nuevos. Huntley dice que la técnica funciona mejor así, y todavía no lo hemos probado en un proyecto grande que ya existe.
La revisión entre agentes encuentra errores reales, pero no sustituye a la de una persona. Si el proyecto importa, hay que leer los pull requests.
Cómo probarlo
Lo primero que hace falta es el servidor de tareas. No forma parte de este repositorio, pero su especificación sí: docs/central-prd-spec.md describe la API, las reglas de reparto y el tablero. Es corta y se puede implementar en cualquier lenguaje. Nosotros construimos el nuestro con un bucle de Ralph normal, de un solo agente y con la lista de tareas en un fichero, a partir de esa especificación.
Con el servidor en marcha, abre Claude Code en tu proyecto y dale este prompt:
I want to use https://github.com/mbernet/ralph-wiggums to develop this project autonomously. Follow https://github.com/mbernet/ralph-wiggums/blob/main/SETUP.md

- Spec(s): <ruta de tu especificación>
- Ralph API: https://tu-servidor/api/ralph
- API token: <token>

Get everything ready, then tell me briefly how to start the loop.
El agente comprueba el entorno, prepara una copia separada del repositorio para el worker, convierte la especificación en tareas y te las enseña para que las revises. Al terminar te da el comando para arrancar.
Nuestra recomendación es empezar con un proyecto nuevo y pequeño, poner el modelo barato a implementar y seguir el avance en el tablero.
