A Liquid Studio fa temps que treballem amb agents d'IA que programen sols. Els dones una llista de tasques i un agent les va resolent una darrere l'altra, sense que ningú hagi d'estar pendent de cada pas. Ens ha permès tirar endavant feina que abans demanava molta més atenció. En aquest article expliquem com ho hem ampliat per posar diversos agents d'IA en un mateix projecte, per si treballes amb agents o t'ho estàs plantejant.
Com més ho fèiem servir, més clar vèiem el que hi faltava, i ho vam resumir en dos objectius.
El primer era la qualitat. En un equip, el codi no passa directament de qui l'escriu a producció: algú comprova que fa el que es va demanar, algú revisa com està escrit i després s'integra. Amb un únic agent, el que programa és el mateix que decideix que la feina està bé. Volíem que cada tasca passés per diverses fases i que cada fase la fes un agent diferent.
El segon era tenir una visió global. Amb l'enfocament habitual, la llista de tasques viu en un fitxer dins del projecte, a l'ordinador on corre l'agent. Així és difícil veure com va el desenvolupament, revisar el que s'ha fet, afegir una tasca a mig camí o posar diversos agents en el mateix projecte. Volíem centralitzar-ho en un tauler estil Trello, amb tots els projectes, l'estat de cada tasca i la seva pull request, i amb fluxos de treball diferents segons el tipus de projecte.
El resultat és ralph-wiggums, que hem publicat com a codi obert. Muntar la infraestructura perquè un agent treballi sobre sistemes reals també forma part del nostre servei d'intel·ligència artificial. Més avall expliquem com funciona i per què vam prendre cada decisió.
El punt de partida: el patró Ralph
Ens basem en un patró de Geoffrey Huntley que es diu Ralph. Parteix d'una observació: un agent que treballa molta estona en la mateixa sessió acumula intents fallits, fitxers que ja no importen i decisions descartades, i raona pitjor com més soroll arrossega. Ralph ho evita amb un bucle que llança un agent nou per a cada tasca. L'agent comença sense memòria, fa una sola cosa i acaba. El que necessita saber ho troba al repositori: el codi, l'historial de git i una especificació.
Ryan Carson el va convertir en una eina, snarktank/ralph. Un script llegeix una llista de tasques d'un fitxer, llança un agent per a la següent pendent i repeteix. El que aprèn cada agent queda apuntat en un altre fitxer per al següent.
Aquesta és la base. Tots els canvis que expliquem a continuació surten d'alguna cosa que ens fallava en fer-la servir.
Les tasques en un lloc central
Mentre la llista de tasques sigui un fitxer en una sola màquina, ningú més pot veure'n l'estat, afegir tasques ni treballar en paral·lel. Així que la vam treure a un servidor amb una API petita.
El servidor guarda els projectes i les seves tasques. De cada tasca en guarda l'especificació, que escriu una persona i serveix de referència per a qualsevol decisió; un estat mínim amb la fase en què és, la seva pull request i si està encallada; i un historial de tot el que hi han fet els agents, amb qui hi va treballar, amb quin resultat i què va deixar escrit.

Damunt de l'API hi ha un tauler amb les tasques en quatre columnes: pendents, en curs, aturades i fetes. Cada targeta mostra la fase de la tasca, qui hi està treballant, l'enllaç a la seva pull request i, si alguna cosa va malament, el motiu. Les tasques es poden editar o afegir amb el desenvolupament en marxa, i els agents les recullen a la volta següent.
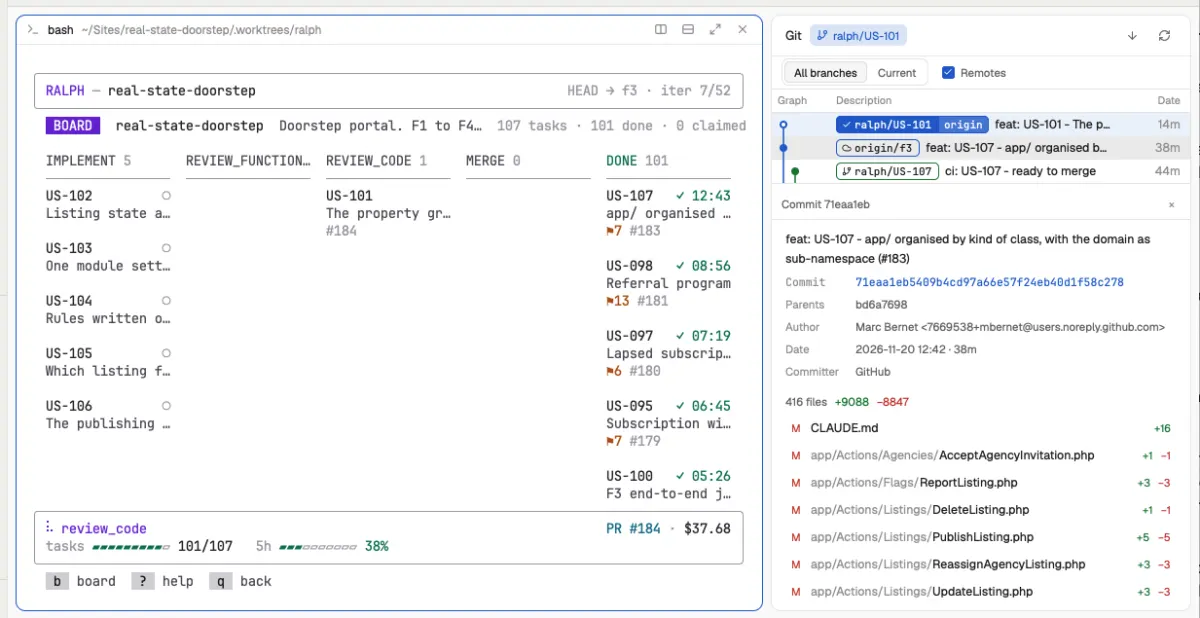
Cada worker també té la seva pròpia vista al terminal. Aquesta és la d'un projecte real amb 107 tasques, ordenades per la fase en què és cadascuna:
Diversos agents d'IA sense trepitjar-se
Amb dos agents en el mateix projecte, tard o d'hora tots dos agafen la mateixa tasca si ningú ho impedeix. Per això reparteix el servidor.
Cada agent corre dins del que anomenem un worker: l'script de Ralph sobre la seva pròpia còpia del repositori, en qualsevol màquina amb accés al servidor i a GitHub. Quan un worker demana feina, el servidor tria una tasca i li la reserva durant dues hores. Triar i reservar és una sola operació, de manera que dos workers mai no reben la mateixa tasca.
L'ordre de repartiment intenta no llençar feina. Un worker rep primer les tasques en què ja era, perquè té la branca en local; després, tasques noves; i al final, les que va deixar un altre worker. Dins de cada grup surten abans les més avançades, per tancar abans d'obrir, i una tasca no s'entrega mai mentre hi hagi tasques de les quals depèn sense acabar.
Només l'script parla amb el servidor. Si l'agent tingués accés a l'API, podria agafar una tasca que no li toca o deixar l'estat a mitges. Per això rep la informació de la seva tasca, fa la feina i deixa el resultat en un fitxer, que l'script valida abans d'enviar-lo. L'agent no veu mai les credencials.
Memòria compartida
Cada agent comença sense memòria, i un que no sap què han fet els anteriors acaba repetint feina o trencant el que ja funcionava.
Per evitar-ho, l'agent rep amb la seva tasca tot l'historial d'aquella tasca i un resum de cada tasca ja acabada del projecte. L'historial li explica què es va intentar i què van comentar els revisors. Els resums li diuen on és cada cosa al codi: un agent que comença una tasca sobre el moviment de les peces d'un joc ja sap en quin fitxer hi ha aquest codi, perquè ho va deixar anotat l'agent que el va escriure.
Qui programa no aprova
Si l'agent que escriu el codi és el mateix que decideix que està acabat, un malentès de l'especificació passa sense que ningú el vegi. Per això cada tasca passa per diverses fases, i cada fase la fa un agent diferent que comença de zero. El flux per defecte és el d'un equip:
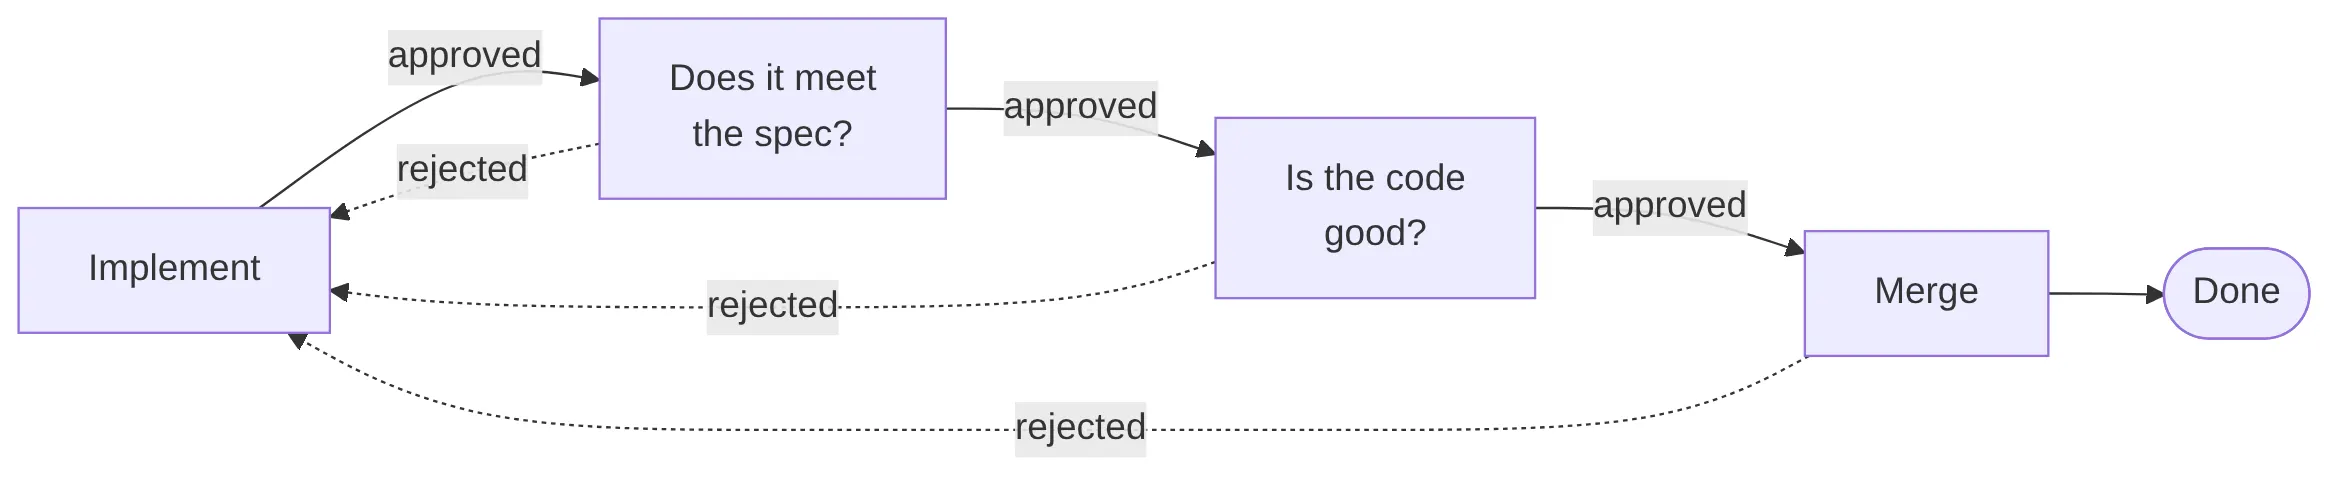
El primer agent implementa i obre la pull request. El segon la compara amb l'especificació sense saber com es va escriure. El tercer revisa la qualitat del codi. L'últim actualitza la branca, espera que passin els tests, fa el merge i escriu el resum de la tasca.
Els revisors arreglen el que poden a la mateixa branca i aproven. Les tasques són petites, així que gairebé sempre surt més a compte corregir en el moment que retornar la feina. Quan el problema és de fons, rebutgen la tasca i torna a la primera fase amb el seu comentari a l'historial, que el següent implementador llegeix abans de començar.
Cada projecte defineix les seves pròpies fases. El servidor no sap què fa cadascuna; només distingeix la primera, que crea la pull request, les intermèdies, que poden rebutjar, i l'última, que tanca la tasca. Un projecte senzill es pot quedar en implementar i revisar, i un altre pot afegir una fase de seguretat. Per afegir una fase n'hi ha prou d'escriure'n les instruccions.
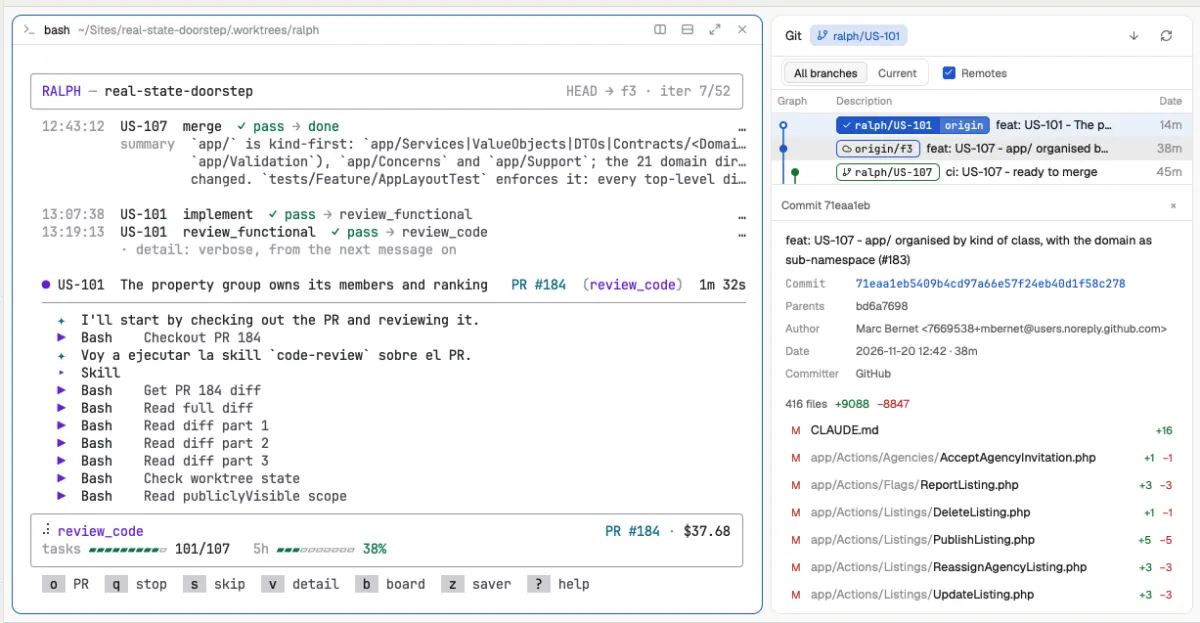
Mentre treballa, la vista del worker ensenya les fases per les quals ha passat cada tasca i el que està fent l'agent en aquell moment. En aquesta captura, el revisor de codi acaba de rebre la pull request #184:
Una prova amb un Tetris
Per provar-ho vam escriure l'especificació d'un Tetris per a macOS en Rust. Eren unes 400 línies amb les peces, les rotacions, la velocitat de caiguda per nivell, la puntuació, els controls i el dibuix de la pantalla. El projecte de partida només obria una finestra buida.
Un agent va dividir l'especificació en dotze tasques i ens les va ensenyar abans de carregar-les. Va ser l'únic moment en què vam intervenir, i és on més pesa el criteri d'una persona, perquè com es parteix la feina condiciona tot el que ve després.
A partir de la quarta tasca vam posar Haiku, el model més barat d'Anthropic, a implementar, i vam deixar Opus a les revisions. Volíem veure què passava amb un implementador més feble i revisors més forts.
Els revisors van trobar tres errors. La comprovació de col·lisions de les peces estava escrita dues vegades, i el revisor de codi la va deixar en un sol lloc. El segon tenia a veure amb el terra: quan una peça el toca té mig segon per moure's, i cada moviment reinicia aquest temps, com a molt quinze vegades. El codi de Haiku permetia saltar-se aquest límit girant la peça, així que una peça podia no fixar-se mai. Cap test no ho cobria; el revisor ho va corregir i va afegir el test. El tercer el va trobar el revisor que compara amb l'especificació: les peces noves trigaven dos segons a aparèixer a la pantalla, l'especificació demanava una altra cosa i ho va corregir.
En una mica més d'una hora de feina dels agents teníem un Tetris complet i jugable, amb una pull request fusionada per cada tasca acabada. Claude Code calcula un cost equivalent d'uns 12 dòlars; amb una subscripció, el que es gasta és part del límit d'ús.
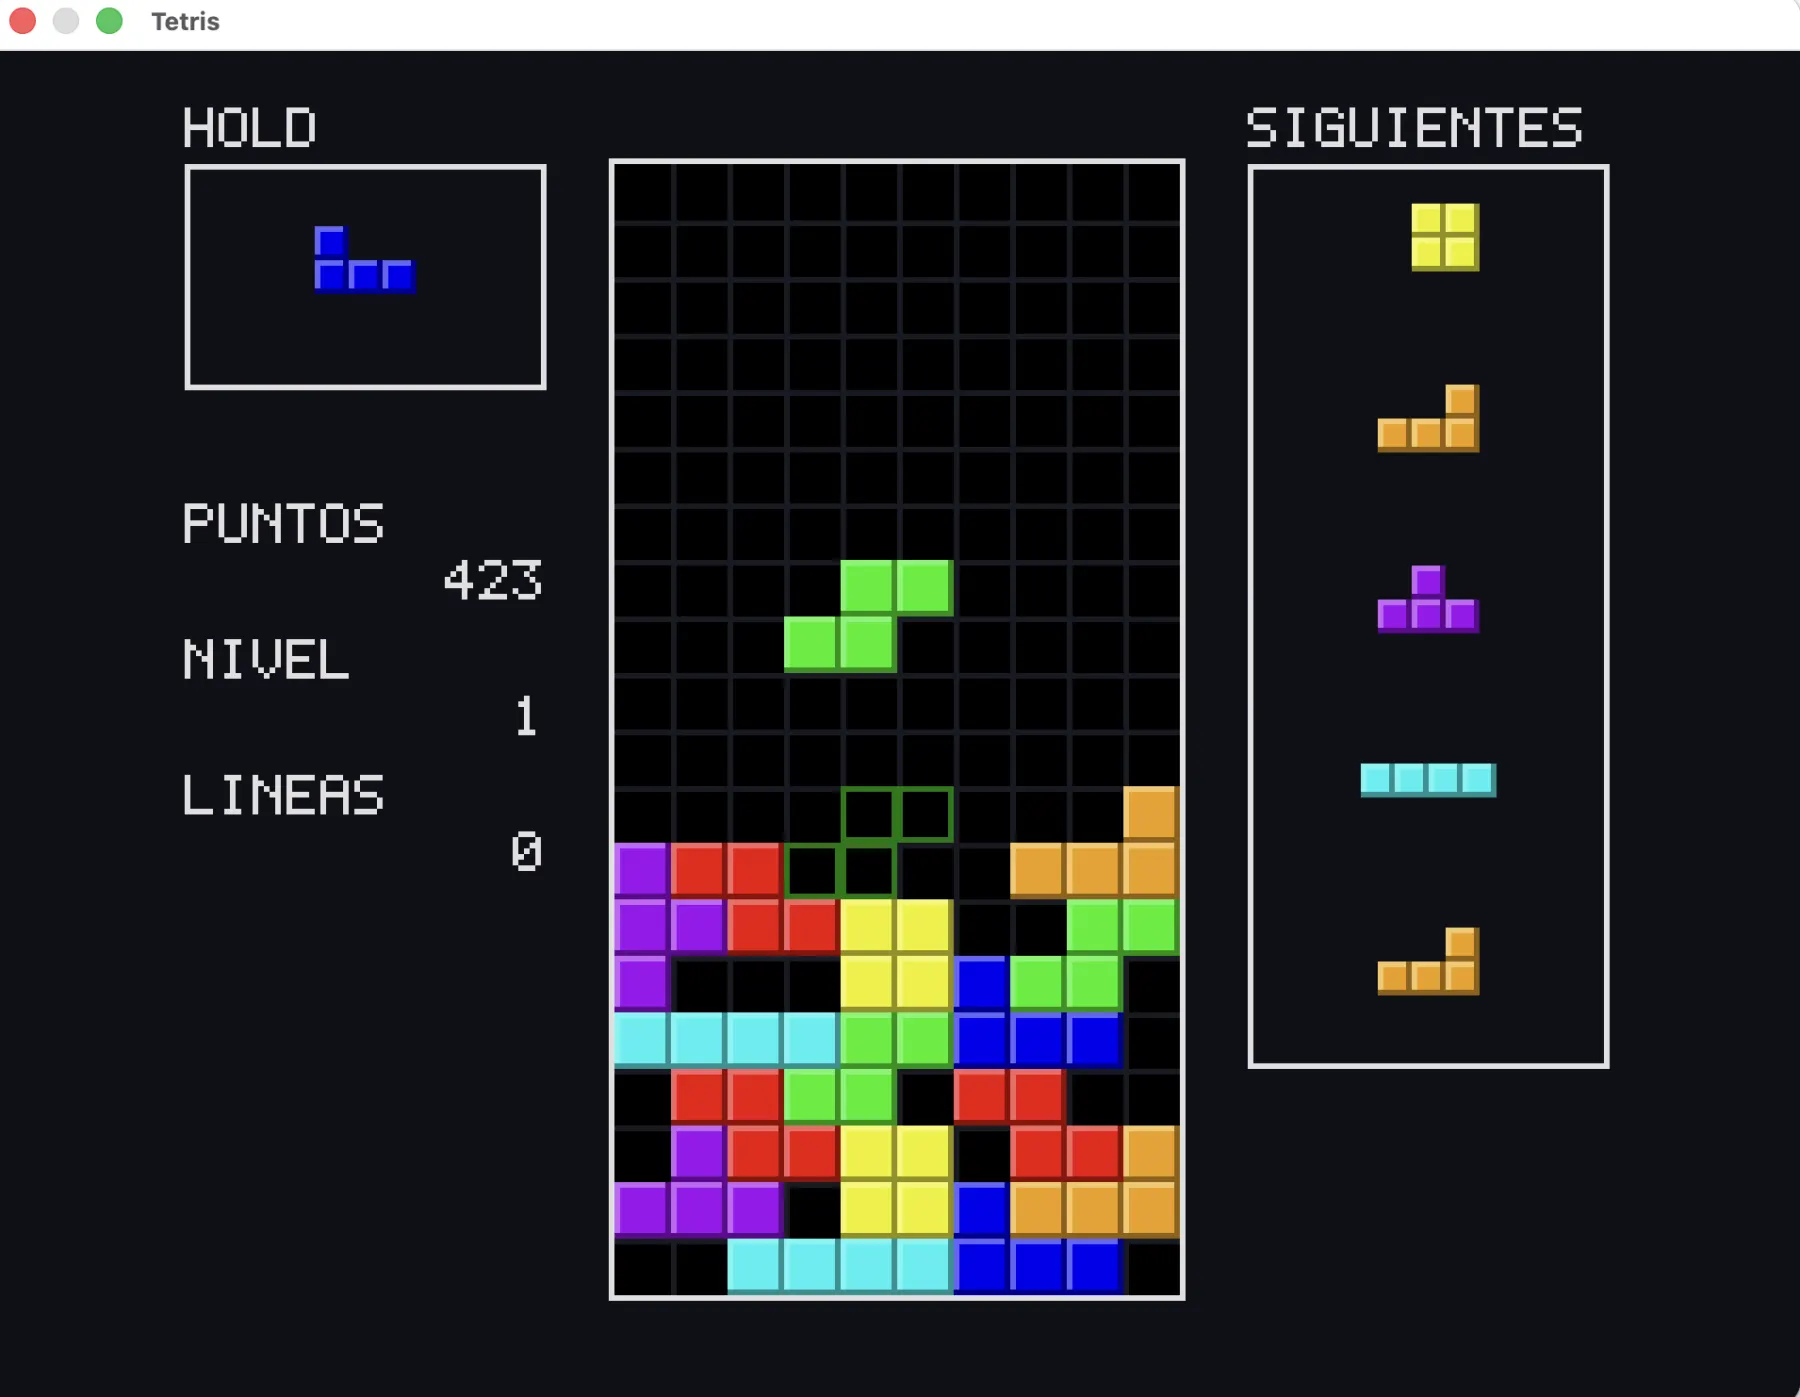
El Tetris que van fer els agents, funcionant a macOS
Quan una tasca no pot avançar
Un agent que treballa sol no té a qui preguntar. Si s'encalla, es pot inventar una sortida o quedar-se fent voltes sense fi, així que hi ha una resposta per a cada nivell de gravetat.
Davant d'una ambigüitat, l'agent tria el que encaixa millor amb l'especificació i deixa escrita la seva suposició perquè la vegin els revisors.
Quan no pot avançar perquè l'entorn està trencat, falta un accés o l'especificació es contradiu, marca la tasca com a encallada i explica per què. Aleshores la tasca passa a un agent especialitzat, que anomenem doctor, que investiga la causa i decideix què fer-ne.
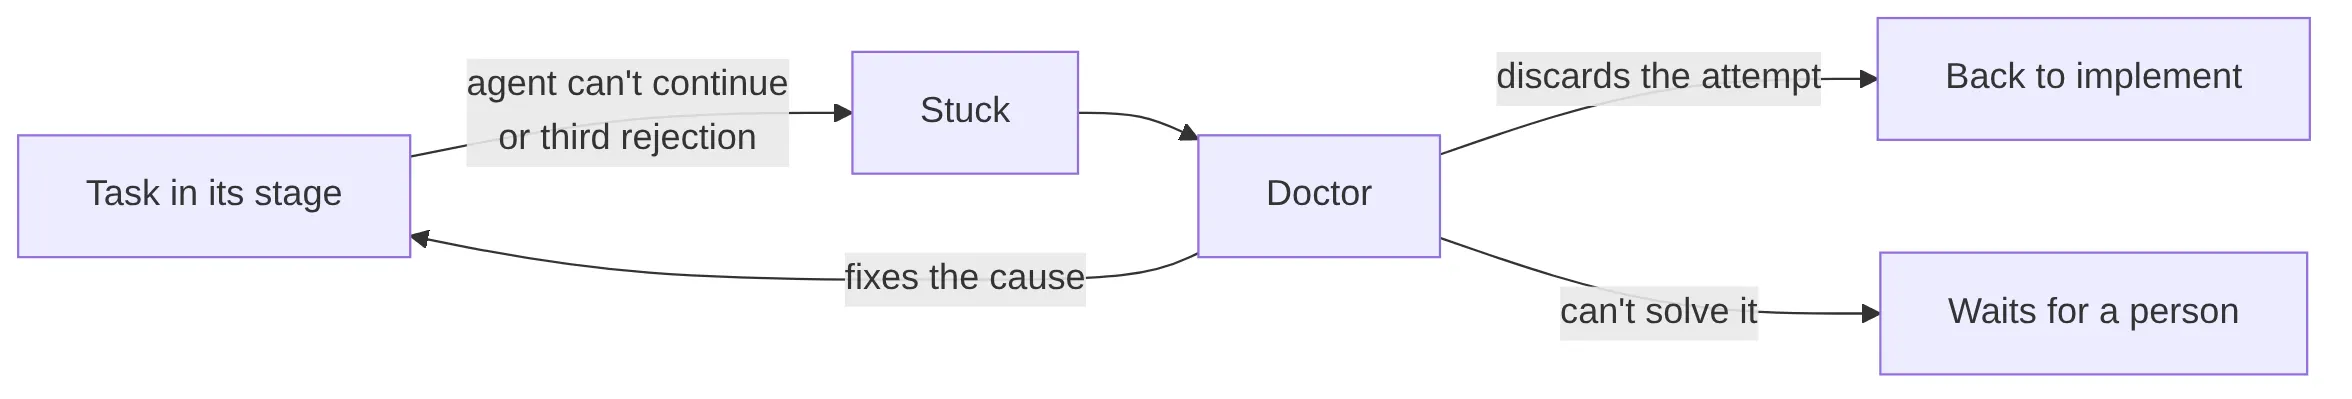
Al Tetris va passar amb un error nostre: l'especificació donava dues velocitats diferents per al nivell 1. L'agent no va escriure codi i va explicar la contradicció. El doctor va deduir quin valor era el correcte, va corregir l'especificació i la tasca va continuar.
Els límits són fixos perquè cap cicle no es repeteixi sense control. Una tasca rebutjada tres vegades passa al doctor, i el doctor intervé com a molt dues vegades en la mateixa tasca. Si no ho resol, la tasca s'atura juntament amb les que en depenen i apareix a la columna d'aturades del tauler, amb el diagnòstic.
El consum sota control
Una subscripció de Claude té dos límits d'ús, un que es reinicia cada cinc hores i un altre de setmanal. Un bucle que treballa sol pot esgotar el de la setmana en una nit, de manera que el worker vigila el seu ritme abans de cada execució. Si va més de pressa del que li permetria acabar la finestra de cinc hores sense passar del 85 %, fa una pausa. Si la següent execució superaria el límit, espera que es reiniciï, i si s'esgota el límit setmanal, s'atura.
Al Tetris, el worker va arribar a portar un 31 % consumit a l'hora i tres quarts de finestra. Com que anava una mica de pressa, va esperar tres minuts i mig i va continuar.
També es pot triar quin model fa cada fase. Amb dues línies de configuració, el model barat implementa i les revisions en fan servir un de millor:
RALPH_STAGE_IMPLEMENT=low
RALPH_MODEL_LOW=haiku
És la combinació que millor ens ha funcionat: el model barat fa el gruix de la feina i els revisors corregeixen el que se li escapa.
Tres workers alhora
La segona prova va ser un programa d'escacs per al terminal, amb tres workers en paral·lel i Haiku a totes les fases, revisions incloses.
Tres tasques diferents necessitaven el mateix fitxer i cadascuna el va crear des de zero a la seva branca. La primera es va integrar sense problemes i la segona va entrar en conflicte amb ella. L'agent de la fase de merge va combinar les dues versions, va reanomenar una funció que apareixia a totes dues, va passar els tests, va fer el merge i va deixar escrit com ho havia resolt per a qui hagués d'integrar la tercera.
Una de les tasques va passar pels tres workers. Un la va implementar, un altre en va revisar el codi i el tercer en va fer el merge, sense que cap sabés res dels altres: el servidor va donar cada fase al worker que estava lliure. Van ser catorze tasques en mitja hora, amb un cost equivalent de 65 cèntims.
Ajustar les instruccions
Els agents cometen errors que es repeteixen, i corregir cada resultat a mà no escala. Huntley proposa corregir les instruccions, i ho compara amb afinar una guitarra. És la part que més temps ens ha portat, i gairebé mai no ha calgut una regla nova. Sol n'hi ha prou de formular millor una que ja existeix.
Per exemple, els agents només veien les tasques acabades, no les pendents, i de vegades deixaven feina "per a una tasca posterior" que no existia. Ho vam resoldre ampliant una regla que ja tenien:
- **Decide instead of asking.** Nobody is there to answer.
+ **Decide instead of asking or deferring.** Nobody is there to answer, and no later task is promised.
Convé tocar el mínim. Unes instruccions que funcionen són fràgils, i un paràgraf nou pot canviar comportaments que no tenien res a veure amb el que volies arreglar.
El que no resol
L'especificació continua sent feina d'una persona. Tot el que va sortir bé en aquestes proves partia d'especificacions amb criteris d'acceptació comprovables; amb una especificació vaga, els agents omplen els buits amb suposicions.
Només l'hem fet servir en projectes nous. Huntley diu que la tècnica funciona millor així, i encara no l'hem provat en un projecte gran que ja existeix.
La revisió entre agents troba errors reals, però no substitueix la d'una persona. Si el projecte importa, cal llegir les pull requests.
Com provar-ho
El primer que cal és el servidor de tasques. No forma part d'aquest repositori, però la seva especificació sí: docs/central-prd-spec.md descriu l'API, les regles de repartiment i el tauler. És curta i es pot implementar en qualsevol llenguatge. Nosaltres vam construir el nostre amb un bucle de Ralph normal, d'un sol agent i amb la llista de tasques en un fitxer, a partir d'aquesta especificació.
Amb el servidor en marxa, obre Claude Code al teu projecte i dona-li aquest prompt:
I want to use https://github.com/mbernet/ralph-wiggums to develop this project autonomously. Follow https://github.com/mbernet/ralph-wiggums/blob/main/SETUP.md

- Spec(s): <ruta de la teva especificació>
- Ralph API: https://el-teu-servidor/api/ralph
- API token: <token>

Get everything ready, then tell me briefly how to start the loop.
L'agent comprova l'entorn, prepara una còpia separada del repositori per al worker, converteix l'especificació en tasques i te les ensenya perquè les revisis. En acabar et dona l'ordre per arrencar.
La nostra recomanació és començar amb un projecte nou i petit, posar el model barat a implementar i seguir l'avenç al tauler.
